01/ 01
章节
封面

OrchTech
协律科技

面向开放世界长程自主移动操作的机器人决策模型

Orchestrating  Perception · Prediction · Action

协律感知、预测与执行 —— 让机器人与环境、与人协律而行

The Thesis

  • 具身机器人的核心命题:

    能力边界正在迁移

    01
    从固定走向开放

    固定场景、固定任务 → 开放世界

    02
    从短动作走向长程自主

    短动作执行 → 长程自主任务

    03
    从模仿走向自主决策

    依赖专家数据 → 自主理解、规划和恢复

    端到端模仿学习以直接“observation-to-action”的动作生成范式(如 VLA、WAM),泛化能力高度依赖训练数据的覆盖范围,无法适应开放、长程、高交互任务。随着 GPT-6 Astra 等通用 VLM 的多模态理解、复杂推理与多步规划能力跃升,专用动作生成模型的必要性及能力上限正受到直接挑战。

  • 协律科技的核心判断:
    • 模型应该具备理解空间(空间智能)、理解“行动怎样改变世界”的能力,支持规划模块在与模型、环境交互中自主探索出完成任务的最优解(Predictor + Planner),而不是单纯依靠堆积数据拟合专家数据分布。
    • Beyond 模型,如何做好基于模型的机器人 Harness,使模型能力能够鲁棒、稳定地作用于真实场景,尤为重要。具身机器人的重心不是与 VLM 基模公司(OpenAI、Anthropic 等)竞争基模能力,而是打造连接模型能力与物理世界执行的关键环节,让通用模型的进步持续转化为公司的能力增量。
    • 在长程、开放空间的自主移动操作任务中,单纯依靠 VLM 依然无法直接控制机器人。虽然 VLM 具备越来越强的场景理解和 Tools / Skills 调用能力,但要高效完成此类任务,仍需要围绕其最擅长的 Scene Understanding 能力,打造一套属于机器人的 Harness System。具备丰富此类任务经验的团队,会更擅长构建这样的 Harness,贯通从场景理解、Geometry / Metric Grounding、任务规划,到各类 Contact-Rich 移动操作 Skills 的完整链路。

Click to reveal core judgment 01

OrchTech Route

协律科技的核心技术路线

围绕三个相互连接的环节展开

01 · 上层

空间理解

吸收最强通用智能,理解空间、目标并组织任务;构建表达“机器人—环境—待操作物体”语义、空间等关系的多模态3D场景地图(Scene Graph)。

→
02 · 中层

预测规划

基于 JEPA 的自有模型在潜空间预测机器人动作条件下的世界变化,维护环境状态、根据不同任务规划最优移动操作空间轨迹、编排技能并处理失败。

→
03 · 底层

动作执行

以满足时延和精度要求的跨物体操作策略(Skills)与控制器完成物理执行。

CORE INTERFACE

构建连接“空间理解—预测规划—动作执行”的通用信息接口,以统一表征贯通三层任务。

行业趋势

机器人系统 Harness 与世界模型发展脉络

主线一 · ROBOTICS HARNESS

系统架构从更大的端到端动作模型,转向显式的分层分工。

  • 2022
    SayCan · Code as Policies

    语言模型进入机器人决策栈

  • 2025
    Hi Robot · GR00T N1

    双系统成型:慢速语义推理 + 快速动作专家

  • 2026
    Pigey 提出 orchestration gap

    同一冻结 VLA 加入编排器,LIBERO-PRO 12.8% → 53.3%

  • 2026.07
    Gemini Robotics 2

    ER2 语义规划与进度跟踪,VLA 负责执行

主线二 · PREDICTOR + PLANNING

从预测像素、拟合专家数据并直接生成动作,转向预测行动带来的世界变化;动作生成则由 Planner 模块通过与模型交互的最优化计算过程完成。

  • 2022
    LeCun 提出 JEPA

    2018 年图灵奖得主提出:预测表征而非像素

  • 2024.02
    V-JEPA

    把「预测未来像素」替换为「预测未来表征」

  • 2024.11
    DINO-WM

    冻结视觉基座 + latent dynamics,验证 zero-shot planning

  • 2025.06
    V-JEPA 2-AC · 首次真机闭环

    百万小时视频预训练 + 62h 机器人数据

  • 2026.03
    LeWM · 端到端稳定训练

    仅两项 Loss、约 1500 万参数,规划降至 1 秒内

两条主线的完整技术 review 见 Data Room

组织架构

按三层 Agent 分工,各方向均有负责人牵头,层间以统一的动作意图对接

LAYER 1

场景

关系表征与场景结构化

于靖文负责人

港科大 ECE 博士(谭平教授 / 张宏院士)· 华为 2012 实验室 · 深圳市机器人视觉与导航重点实验室

11+ 顶刊顶会(IJRR / T-ASE / RA-L)· IROS 2025 OWN Workshop 最佳论文 · IROS 2026 Best Paper Finalist(基于大模型的空间智能系统)

LAYER 2

模型

JEPA 预测器 + 规划器

曹嘉航负责人 · 预测器

港大博士 · 上海 AI Lab · 腾讯混元专项(全国 44 人)· 00后 · 数学与神经科学背景的AI博士

50+ 顶刊顶会 · Scholar 1000+ 引用

黄稹敏规划器

港科大博后 & 博士(马骏 / 沈劭劼)· UCB 访问学者 · 广汽研究院 L4 自动驾驶

15+ 顶刊顶会,一作 5 篇(T-RO / T-ITS / T-VT / ICRA)

LAYER 3

动作

技能调度与跨本体执行

宋志城负责人 · 整机运控

港科大博士 · 哥大硕士 · 逐际动力 · 戴盟硬件负责人

轮腿机器人 · 可重构底盘 · 移动操作整机

毕志海移动操作

港科大博士 · 复旦硕士

19 篇顶刊顶会,一作 4 篇 · ALORE 一作

徐天遨灵巧手

ETH 硕士(Marco Hutter · RSL 实验室)· 新国立博士

足式强化学习控制 · 灵巧手遥操作与控制

产品 · 市场 · 运营刘映南普渡机器人产品研发 · 曾任上市集团产品部负责人(五十余人团队)· 国内外双市场交付 · 超亿元销售额

第一章 · CHAPTER 01

公司团队

能力验证

模型 × 机器人工程的复合 know-how

在开放场景移动操作与复杂交互规划领域具备系统级顶尖积累。 模型团队往往缺少运动规划、复杂接触、高频控制的经验;传统机器人团队能完成单点动作,却难以用模型实现跨任务泛化。

真实有人环境作业

办公场景边移动边操作,处理多重接触与扰动

模型 · 复杂环境感知工程 · 复杂多任务

灵巧手精细操作

物体旋转等接触丰富的精细操作

模型 · 接触自适应工程 · 灵巧手闭环控制

跨本体执行

同一策略直接驱动腿式整机完成同类任务

模型 · 跨本体策略工程 · 整机控制

单策略跨物体泛化

同一 policy 推形状、材质、重量各异的物体

模型 · 多物体泛化工程 · 鲁棒接触控制

模型泛化与机器人工程的深度耦合:既能应对变化与扰动、实现跨本体泛化,也能在复杂接触和长程任务中稳定运行。

核心团队

HKUST Robotics 核心班底,整建制 PhD 团队。具备感知、理解、规划、控制系统级全栈能力,在开放场景交互式移动操作方面的积累处于业内领先水平
李玉麟
创始人 · CEO

李玉麟

技术与产品战略总负责人

哈佛访问学者 · 新国立博后 · 港科大博士 · UCSD 硕士
  • 移动操作 · 交互式接触与导航 · 物理仿真器 · 隐空间推理世界模型
  • 20+ 顶刊顶会,一作 7 篇
  • IROS 2025 移动操作最佳论文 · 最佳学生论文提名
陈凯
联合创始人 · CTO

陈凯

机器人总负责 · 技术架构与系统闭环

港科大博士后 & 博士 · 中科院大学硕士 · 戴盟联创 · 小鹏
  • 开放场景定位导航 · 复杂环境感知 · 全身运控 · 整机部署
  • 15+ 顶刊顶会,一作 5 篇
  • 李泽湘教授团队博士后 · 工具使用与灵巧手操作
曹嘉航
联合创始人 · 具身与生成式模型负责人

曹嘉航

具身模型总负责 · JEPA 预测器训练

港大博士 · 港科大硕士 · 上海 AI Lab
  • 世界模型 · 视觉语言操作 · 开放词汇导航 · 认知启发模型
  • 50+ 顶刊顶会(ICLR / NeurIPS / ICML / CVPR / ICRA),Google Scholar 1000+ 引用
  • 2026 腾讯混元人才计划(全国 44 人)
马骏
首席科学家

马 骏

  • 香港科技大学 90 后长聘副教授(4 年 Early Tenure)
  • NUS 博士 · Harvard 博士后 · Berkeley 访问学者
  • 国家级人才计划 · 机器人与自动化系主任 · 智能自动驾驶技术中心主任

港深地区人才密度最高、规模最大的 Robotics & AI Lab

200+ 顶级论文 50+ 博士生 70+ 硕士生 数千万科研经费 多个国家级重点项目 华为 · 理想深度合作

公司是马骏教授唯一绑定的产业转化平台,创始人为其第一位学生。核心团队同门并肩多年,决策与执行同频

第二章 · CHAPTER 02

行业趋势

具身智能行业发展回顾

目前行业核心三条技术路线的演化历史

2022 2025H2 路线1 路线2 路线3 神经网络 大模型的 Scaling language vision VLM language vision 更好的有物理规律的 VLM languagevision VLM languagevisionWorld Observe 逆动力学模型 IDM Action 将大模型的Scaling 引入机器人领域 languagevision本体 VLA Action 模仿学习泛化性被质疑 languagevisionWorld Observe点云···本体 WAM ActionWorld Observe 机器人一直以来的训练架构 planner simulator 仿真 state Motion planningAction Predicting + Planning 是 Robotics 一直以来的训练方式过去瓶颈在 simulator 不够“智能”,Planner 偏“传统” planner JEPA predictor Language vision 拓扑 点云 ···World Observe World Observe Motion planningAction 模仿学习 预测规划

行业拐点 · VLM × ROBOTICS

GPT-6 Astra 之后:VLM 越强,机器人 Harness 越重要

通用模型正在接管理解、推理与任务组织;具身公司的价值重心,转向把最强通用智能持续转化为可靠的物理执行。

01 · 上层智能正在通用化
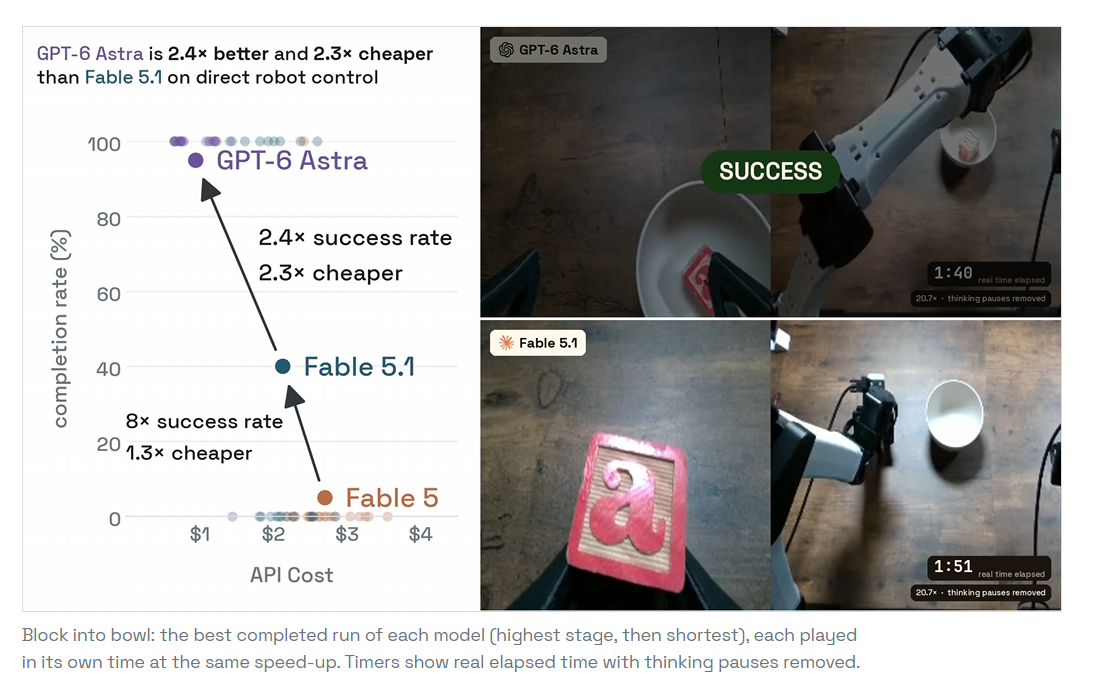
VLM 开始吸收过去由机器人专用模型完成的能力

  • 能力从语言与视觉理解,延伸到空间推理、多步规划与工具调用。
  • Astra 等通用模型已能通过机器人接口输出末端位置、姿态与夹爪意图,进入物理执行闭环。
  • 依赖有限机器人数据微调单一模型的壁垒被削弱;具身公司无需复制基模公司的训练竞赛。
GPT-6 Astra 与 Fable 系列模型的直接机器人控制完成率、成本及方块入碗测试对比
GPT-6 ASTRA · ROBOCURVE DIRECT ROBOT CONTROL

02 · 物理世界仍需系统补齐

Harness 决定智能能否稳定落地

  • Geometry / Metric Grounding:把“看懂物体”转成可抓取、可到达、可交互的几何约束。
  • State / Planning / Recovery:维护长时状态,规划交互顺序,并在执行失败后在线恢复。
  • Contact-Rich Skills / Control:以满足时延和精度要求的策略与控制器完成真实物理执行。

行业价值迁移 · Model → System:VLM 是全行业可复用的上层红利;Harness 决定其能否转化为可靠执行、现场数据与规模化交付。

完整分析与测试见 Data Room

三类动作生成范式与玩家分布

海外三类均有顶级机构推进;国内创业公司高度集中在前两类

视频规划

像素 / 图形渲染

01

作为视频规划器与逆动力学模型(IDM)联合使用,由渲染预测的未来视觉状态反推可行动作,常用于灵巧手操作。
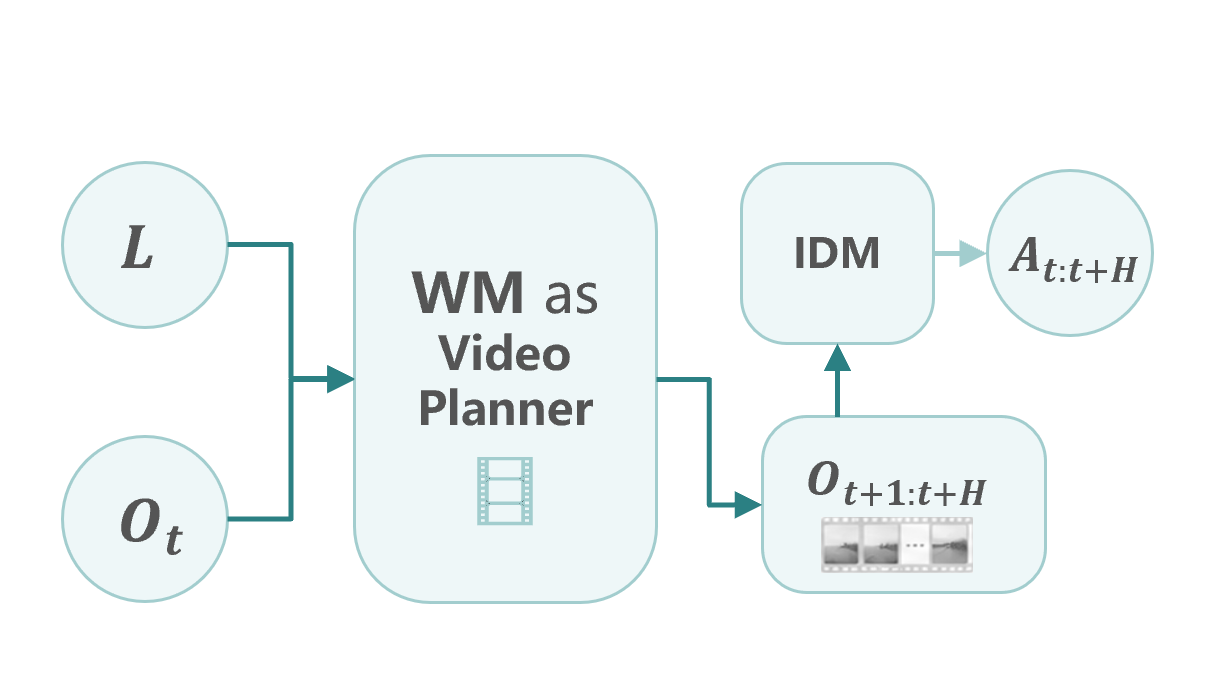
WM 作为视频规划器与 IDM 联合生成动作

端到端规划

直接作为规划器

02

依靠大量专家数据覆盖任务分布,端到端生成动作,跳过机器人"感知-预测-规划-执行"闭环系统的中间环节,适用于固定场景固定任务。
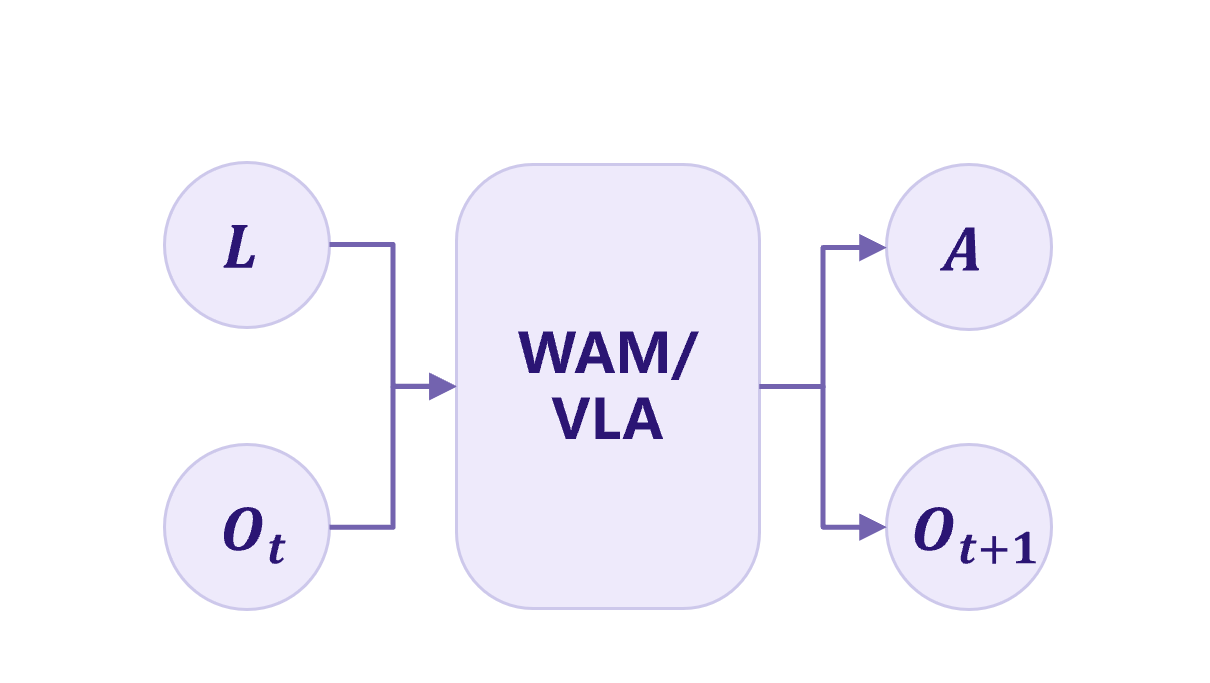
WAM/VLA 端到端直接输出动作

预测 + 规划

作为可交互的预测器

03

基于 JEPA 的隐空间状态预测器 + 规划架构,预测器层理解不同动作下交互状态如何演化,规划层基于预测结果规划最优动作并完成闭环执行。
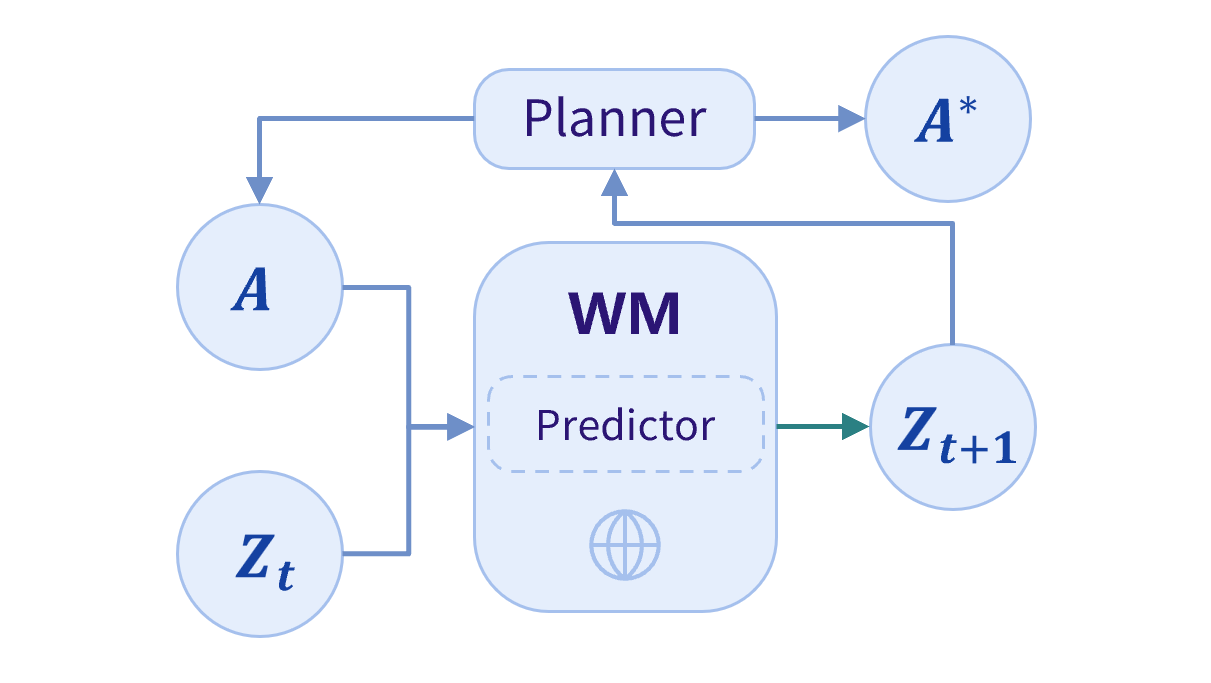
WM 预测器与 Planner 闭环规划

国内多数隐空间世界模型仍以端到端 / RL 监督动作;协律科技依托在开放场景移动操作与复杂交互规划领域的系统级顶尖积累,解耦预测与规划以及动作执行,实现跨场景推演与高频鲁棒执行。

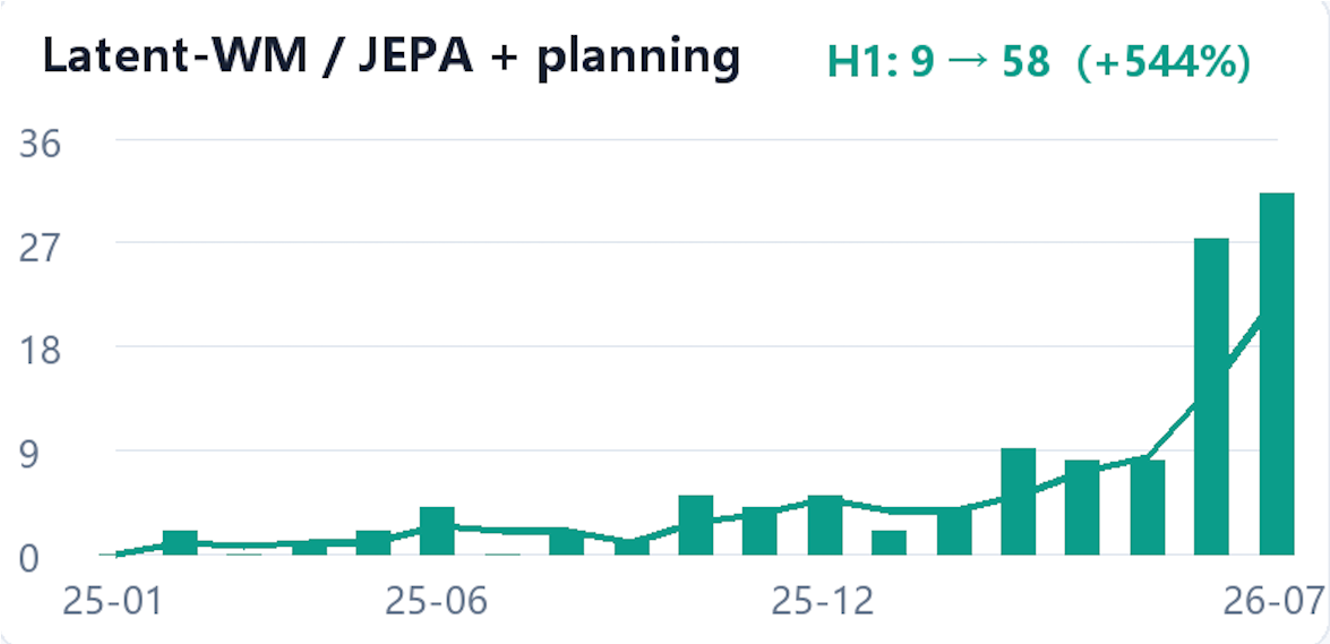
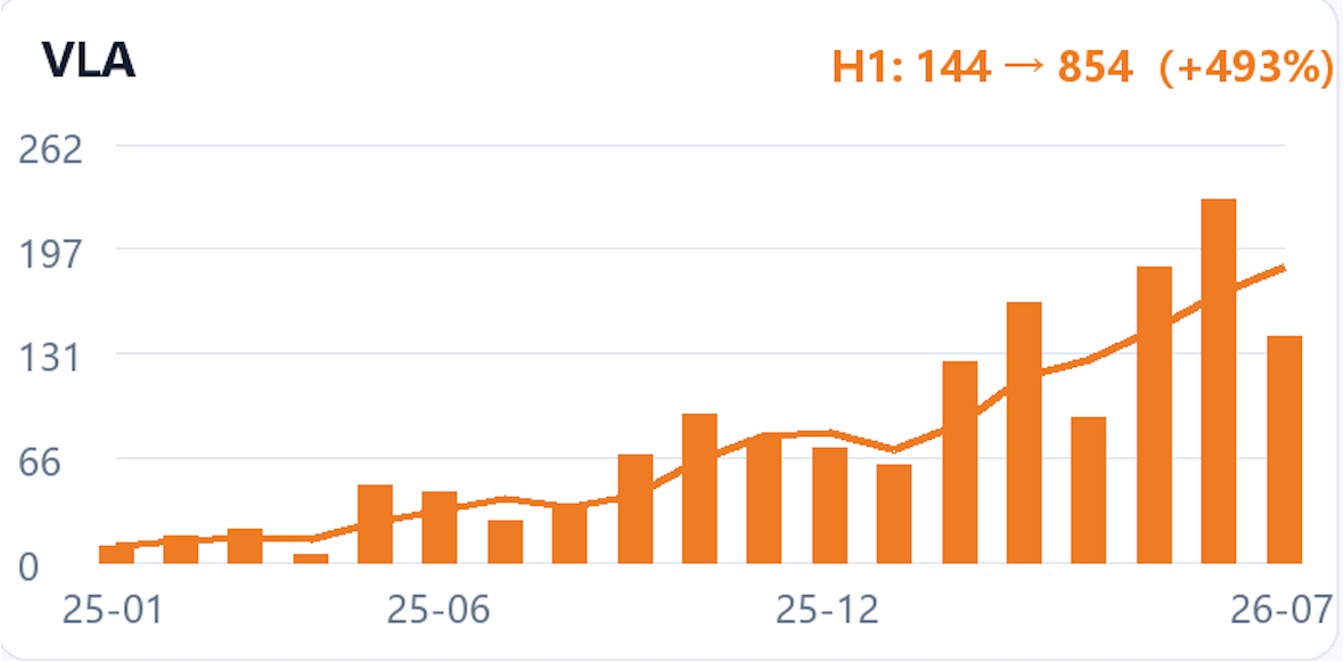
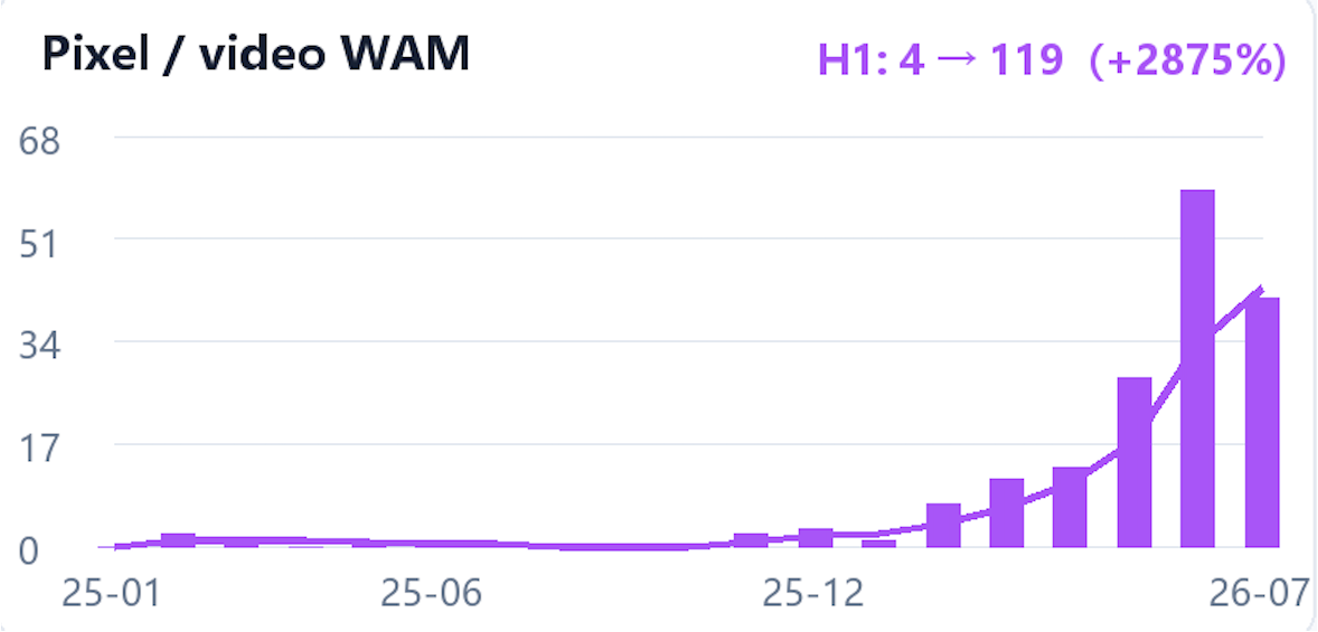
行业内各个研究方向Paper发布趋势

分层(hierarchical)及Predictor+Planning是独立的研究方向,且高速增长

WAM 相关的研究增长迅速,得益于 VLA 创业公司比较多,范式迁移简单,也因此业界声量少。

Predictor + Planning 相关的研究在 LeWM 后快速上涨,但业界声量相对少,主要系相关创业者很少,传导速度有限。
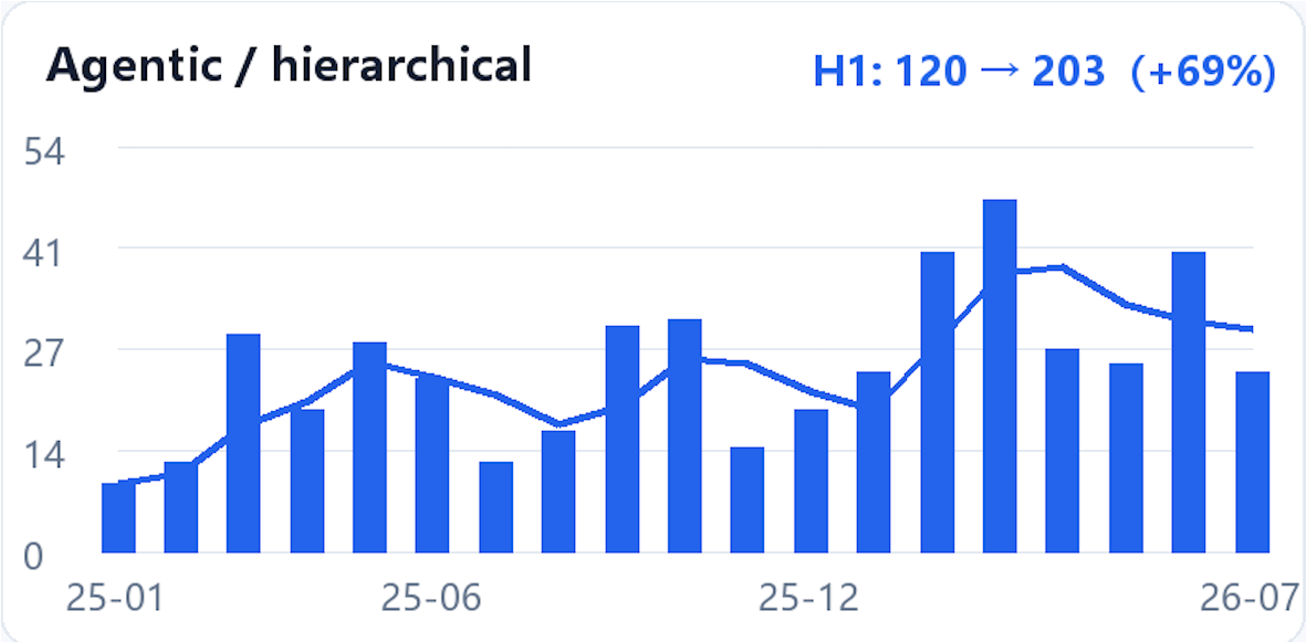
Agentic / Hierarchical

H1 · +69%
Agentic 与分层架构论文发布趋势
共 469 篇

代表演化:Code as Policies → SayCan → VLM + tools → Gemini Robotics 2

Latent-WM / JEPA + Planning

H1 · +544%
Latent-WM、JEPA 与 Planning 论文发布趋势
共 115 篇

代表演化:V-JEPA → V-JEPA 2 → V-JEPA 2-AC → LeWM → JEPA + Planner

VLA

H1 · +493%
VLA 论文发布趋势
共 1,510 篇

代表演化:RT-1 → RT-2 → Open X-Embodiment → OpenVLA → π0 → Gemini Robotics

Pixel / Video WAM

H1 · +2,875%
Pixel 与 Video WAM 论文发布趋势
共 169 篇

代表演化:GR-1 → GR-2 → UniPi → Genie 2 → WorldVLA → DreamZero

数据口径:Google Scholar / arXiv · 2025.01—2026.07

第三章 · CHAPTER 03

技术范式

面向开放世界长程自主移动操作的机器人决策模型

构建连接模型场景理解能力与鲁棒物理世界执行的 Harness。

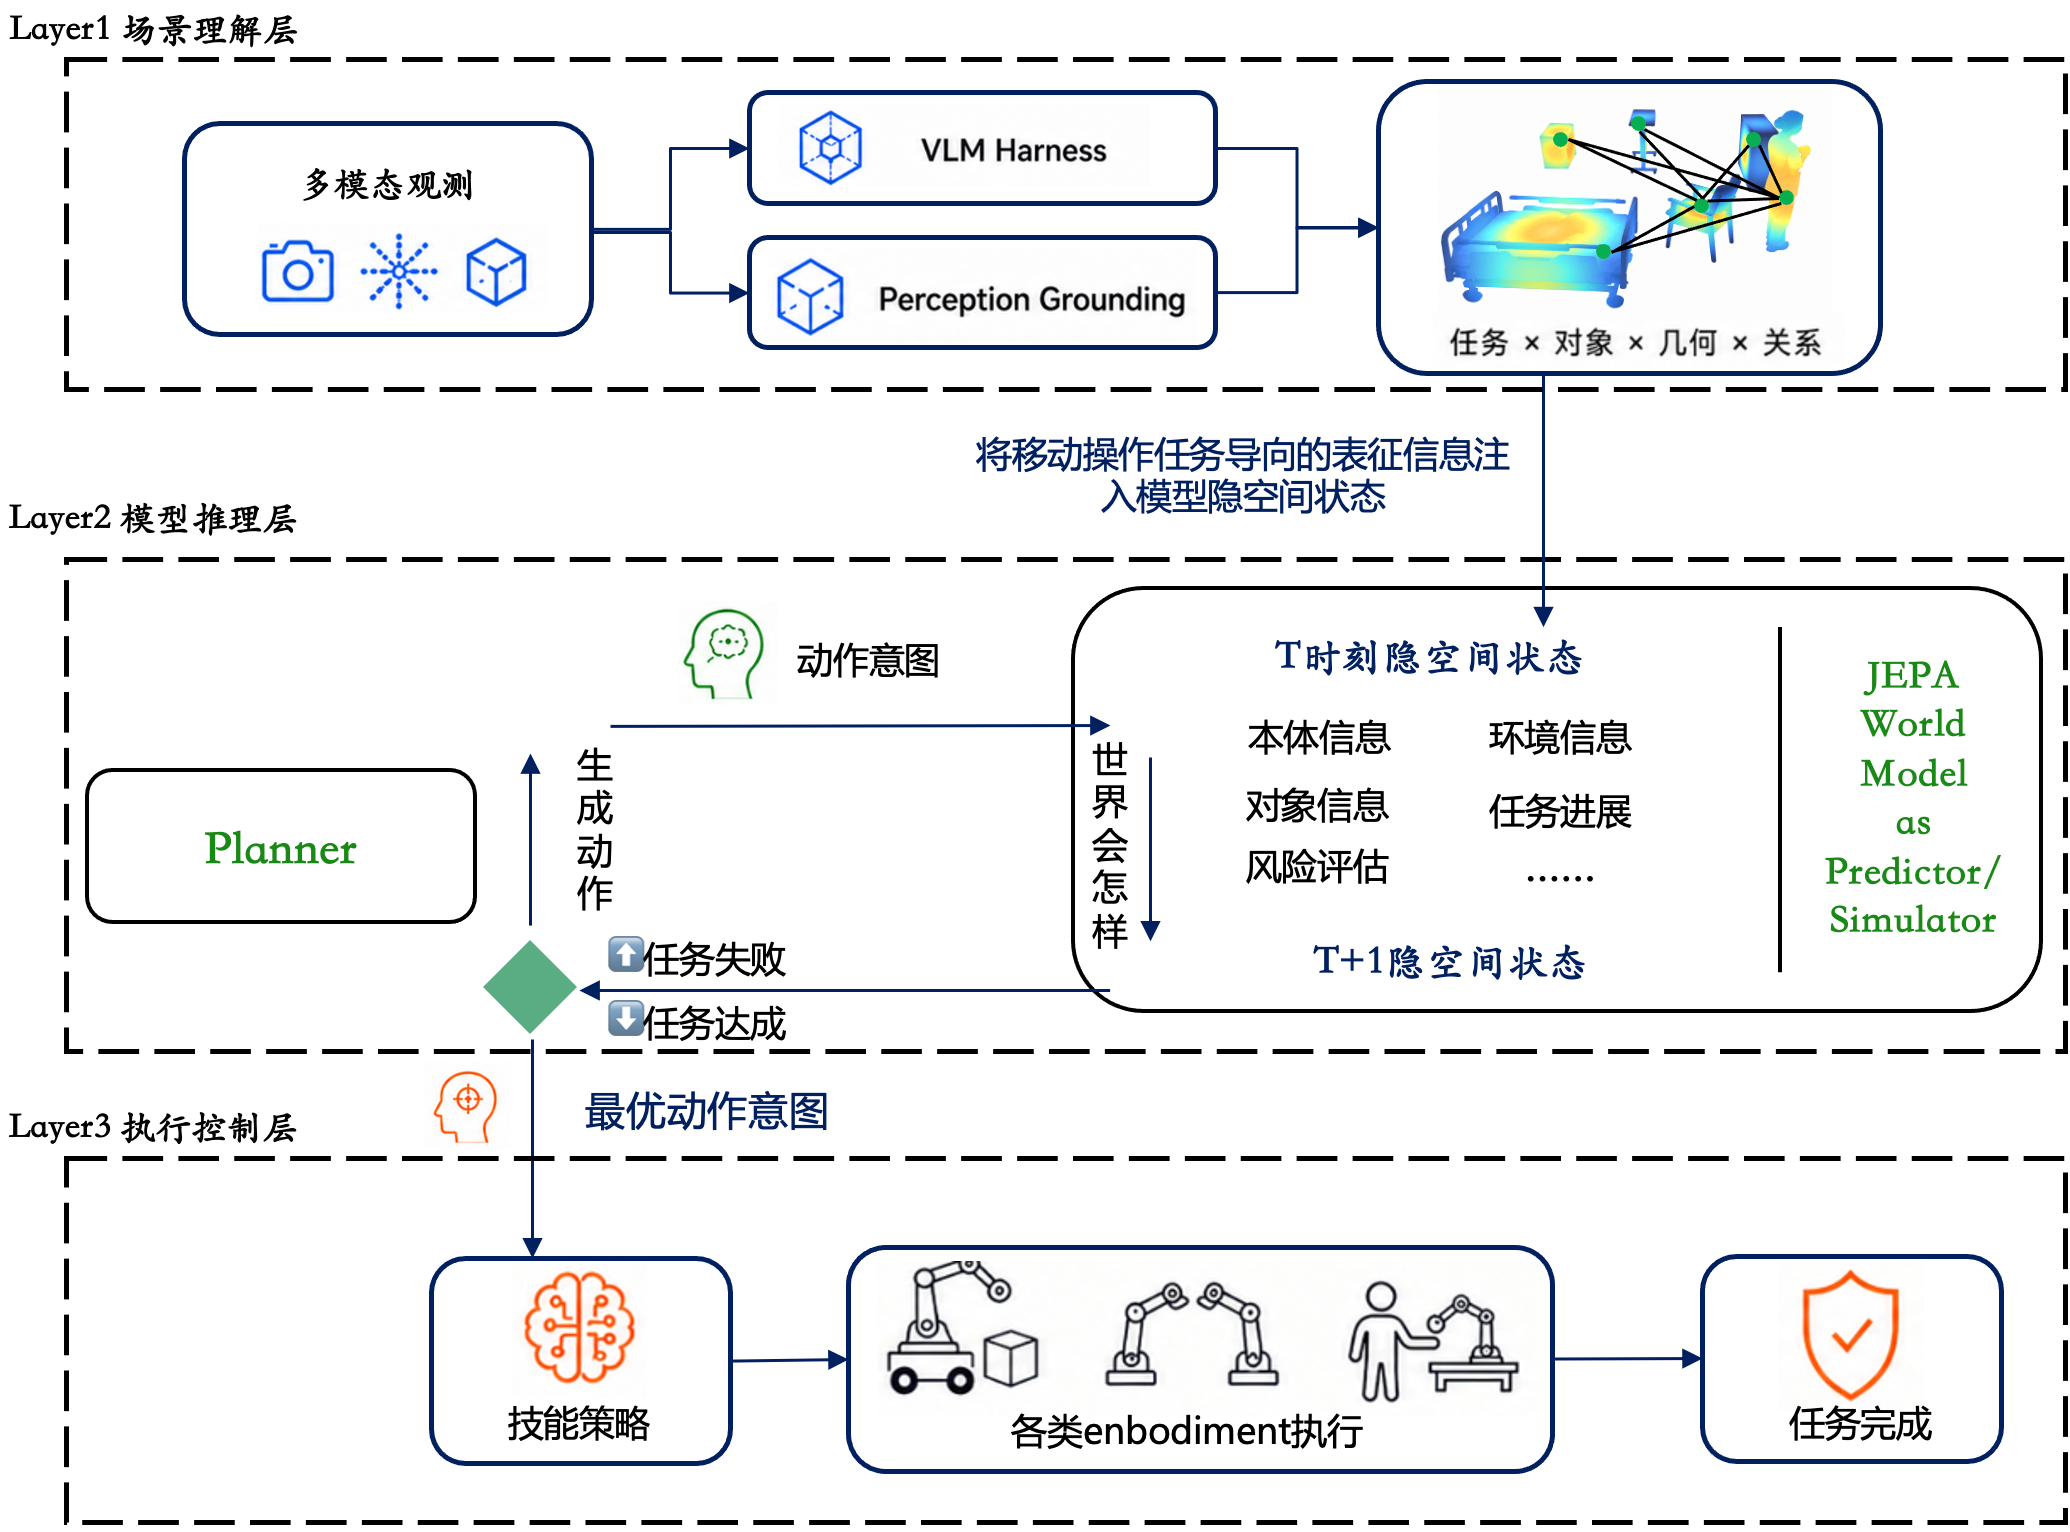
空间理解、预测规划与动作执行协同的分层机器人 Harness

场景理解

LAYER 1

世界是什么样,机器人应该做什么

基于 VLM 的 Harness:从视觉、语言与 3D 信息中提取带几何尺度的空间、拓扑、因果、任务关系,过滤与决策无关的细节,构建多模态 3D 场景地图(3D Scene Graph)。

预测规划

LAYER 2

做了之后会发生什么,据此该走哪条路径

Predictor + Planner:Predictor 在潜空间学习行为如何改变场景关系;Planner 根据任务结合预测演化,optimize 最优动作意图。

动作

LAYER 3

如何以高频、稳定、安全的方式执行

动作意图驱动的技能调度:按意图调度技能库,结合全身控制完成跨 embodiment 闭环执行,执行结果回传上层继续判断与重规划。

分层的泛化优势:场景理解与预测规划层负责跨场景、跨任务迁移;动作执行层负责跨操作对象、跨本体泛化,为同一高层意图选择并适配不同的执行模式。

差异化 01

Relation Driven 的表征积累

以 Relation 作为核心世界表征

学什么 · Relation 表征

世界最本质的表征不是像素,也不是把视觉、语言和物理属性全部塞进模型,而是机器人、物体与环境之间的关系。系统从视觉、语言和 3D 信息中提取空间、拓扑、因果、通行和交互关系。

怎么学 · JEPA

让 JEPA 学习这些关系在机器人动作作用下如何变化,再结合预测和规划产生动作。不以专家数据为前提,因此更容易迁移到新的任务、物体和场景。
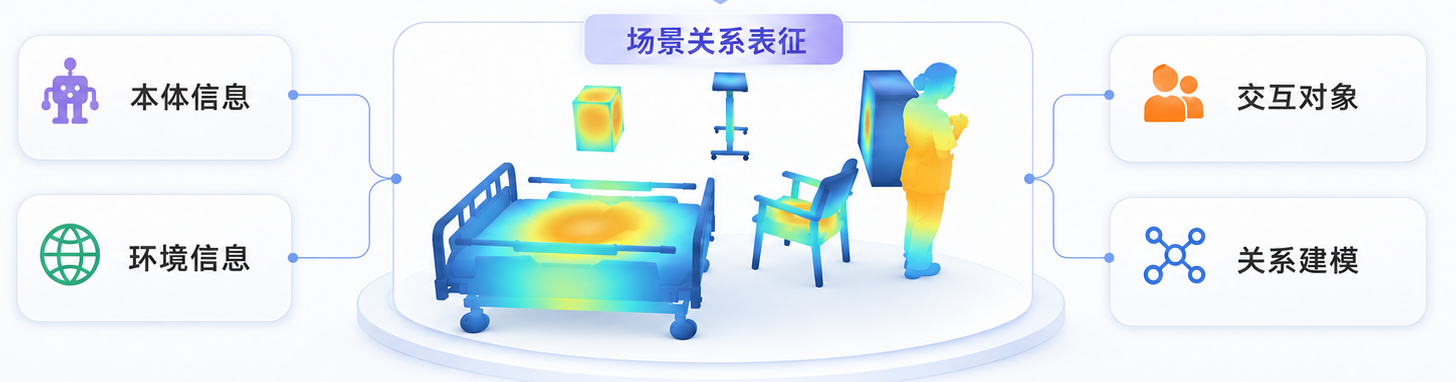
场景关系表征

以椅子为例

不需要预测椅子移动后的每一个像素,只需要判断

01

椅子是否更靠近桌子

02

移开后通道是否打开

03

当前动作是否让任务更接近完成

既过滤了与决策无关的细节,又保留了规划真正需要的信息,使同一套模型可以跨物体、跨任务和跨场景复用。布料操作中的 topology,就是关系表征已经跑通的一个特例。

差异化 02

面向不同层级的分层协同系统

让不同尺度的问题,在合适的层解决

单体端到端模型

一个网络 · 包办所有尺度
场景理解关系推理几何细节力控制
→

协律 · 分层协同系统

上层 · 粗颗粒

跨任务迁移

任务目标场景关系交互顺序
底层 · 细颗粒

本体相关 · 高频闭环

抓取力度摩擦实时纠偏

✕尺度冲突

长程推理与接触控制,压进一个网络互相拖累

→

✓按尺度分工

上层泛化关系,底层泛化控制

✕误差无缓冲

仿真与现实的接触差异,直接传导为执行失败

→

✓底层吸收 gap

高频闭环解决真实接触差异

✕牵一发动全身

加技能、换本体,任何改动都要整套重训

→

✓各层独立迭代

升级单层即可,无需从头重训

数据体系

面对开放世界无法穷举的任务空间,仿真交互数据是更低成本、更能泛化的路线

数据资产金字塔 仿真交互数据的规模化生成 覆盖广 · 通用性高(低特异性) 场景特异性强 · 专有价值高(高特异性) Tier 1 通用先验 Tier 2 仿真数据 Tier 3 真实场景 通用先验 Prior knowledge 网络场景数据 · 开放具身数据 场景分布与任务模式参考 先验辅助 仿真交互数据 Simulated interaction data 规模化 · 自有 · 可控 自动生成状态转移样本 部署校准 真实场景增量 Real-world increment 部署反馈 · 持续校准 仿真设定 Simulation setup 仿真 Rollout Simulation 结构化数据 Structured data 多样场景 办公室 · 零售 · 医院 布局与物理参数随机化 任务目标 初始状态 · 目标状态 任务约束与难度配置 候选动作 动作类型 · 连续参数 位移 / 旋转 / 接触点 虚线 = 时间推进 · 仿真器直接读取对象状态与接触关系 当前场景 + 执行动作 → 未来场景 Gt 结构化场景表征 对象状态与位姿 接触与交互关系 at 动作类型与参数 交互对象 时间步 Gt+n 演化后场景表征 对象状态真值 接触关系真值 JEPA 训练样本:(Gt, at) 条件预测未来隐状态 z,Gt+n 由仿真器提供监督真值。

模仿学习积累的是示教轨迹,会随任务与本体变更而贬值;关系表征与数据管线可跨物体、跨任务、跨场景复用,是真正随时间复利的资产。

第四章 · CHAPTER 04

商业化路径

Demo 01 · Meeting Room

首个场景闭环正在成形

从会议室仿真,到空间理解、动作规划、操作技能与真机本体

SIMULATION→3D MAP→PLANNING→SKILL→ROBOT
01 · Environment + Mapping

会议室 Simulation 与 3D 场景地图

门、桌椅、瓶子及通行空间完成场景化建模

SCENE
02 · Planning

空间轨迹规划

在对象、门与通行空间约束下生成可执行轨迹

DYNAMIC
03 · Door Interaction

自主开门进入场景

移动底盘与双臂协同

LIVE
05 · Hardware

本体与真机验证

Product form → prototype

REAL
04 · Skill

动态 Push & Pull 各类轮式物体

从可操作区域判断到跨对象移动操作

AFFORDANCE

里程碑

核心能力已完成验证,M1 会议室单任务闭环已进入系统联调

已实现 · 能力验证

长时稳定性

连续移动操作

连续多次稳定执行挪动物体的任务

跨域鲁棒性

跨本体与抗干扰

换任务、换本体、现场加重干扰,均鲁棒闭环

复杂接触控制

全身协同与灵巧操作

移动全身协同、协调的抓取操作

世界模型泛化

JEPA + Planning 复杂操作

布料操作跨状态、材质、拓扑泛化。

从能力验证进入场景化验证与复制↓

进行中 · 落地路线

M1当前进展

单任务闭环

在真实会议室完成椅子复位、水瓶摆放与清理,验证轮式双臂稳定移动操作

会议室 · 单任务 · 稳定执行

→
M2

场景级多任务闭环

覆盖会前引导牌与物品布置;会后桌椅复位、台面整理、物品补充与设备关闭

会前准备 · 会后整理 · 多任务协同

→
M3

跨场景复制验证

从会议室复制到办公、餐饮、商超、酒店、医疗等半结构化室内空间,并适配不同能力与成本配置的机器人本体

多场景 · 多任务 · 多本体

OrchTech
协律科技

让具身机器人在开放场景中自主完成真实世界需求

附录:两类动作范式的本质区别

从数学本质角度出发

Imitation Learning

代表VLAWAM
核心思想

“看到这个状态,专家当时做了什么?”

假设

状态:st 动作:at

专家轨迹:τ* = (s0, a0, s1, a1, ···)

学习
πθ(at | st)
st → at

使用神经网络学习直接映射关系

VLA 和 WAM 的本质是状态 s 不一样

  • VLA:vision + language
  • WAM:+ 3D、点云、拓扑等
监督

VLA:在 s 状态下,正确答案是 action a*

WAM:在 s 状态下,st+1 会变成什么,以及正确答案是 action a*

Predictor + Planning

代表JEPA + Planning
核心思想

“做什么动作,世界会怎么变化?”
“哪一条路径能达到目标?”

假设

状态:st 动作:at 目标:g

学习
st, g → a*t:t+H

需要有一个 Predictor 进行推理

st → zt → Predictor → zt+1

搜索不同的动作,预测不同后果

a1→ st+1a2→ s′t+1a3→ s″t+1

先判断哪一个 st+1 能达成目标 g,再比较哪一条路径最优

监督

在 s 状态下,输入 a,st+1 会变成什么?

附录:两类动作范式的本质区别

两者的泛化性来源与核心瓶颈

Imitation Learning

泛化性

为什么容易出现“分布外崩溃”?

如果训练集有:

A → B → C → D

模型学会:A → B,B → C,C → D

但实际执行:A → B′

模型并不知道:B′ → C

泛化思路是学习:B′ / B″ / B‴ / B⁗ → C

举例:如果训练集有

  • 推箱子
  • 拿杯子
  • 开抽屉
→

模型做不到

  • 推椅子
关键瓶颈

学习 B′ -> B⁗⁗⁗

“海量数据”

Predictor + Planning

泛化性

模型学会:

A → B

A → C

A → D

但实际执行:

B、C、D 谁最接近 goal

理论上具备前者没有的一项能力:

组合已有知识,产生训练数据中没有的 action sequence

举例:如果训练集有

  • 左推
  • 右推
  • 前推
  • 后推
→

模型预测如何到达目标位置 goal

  • 先左推
  • 再前推
  • 再右推
关键瓶颈

模型能否正确预测未来?

也需要数据,但不需要左侧那么多;
模型理解模糊意图即可,因为 Planning 可以补齐中间状态的 dynamic。

商业化推进路线

以会议室为首个落地场景,从真实任务验证走向标准产品与跨行业复制

阶段一 · 0—3 个月

完成首个任务闭环

验证系统能否独立完成真实、完整的服务任务

场景与范围

会议室椅子复位、水瓶摆放与清理

客户价值验证

连续完成不少于 20 轮任务,目标完成率 ≥90%,故障后可在 5 分钟内恢复

阶段商业产出

移动操作机器人 MVP,以及首套现场部署与任务验收标准

阶段二 · 3—9 个月

验证场景服务价值

从单一任务扩展为会议室全流程、多任务服务

场景与范围

会前引导与物品布置;会后桌椅复位、台面整理、物品补充及设备关闭

客户价值验证

进入 8—10 个真实办公环境,每类环境连续执行 20 轮,目标完成率 ≥95%

阶段商业产出

面向会议室场景的完整解决方案,以及可复用的部署、验收与运维流程

阶段三 · 9—24 个月

形成可复制产品

验证新增场景能否基于已有系统快速部署

场景与范围

从会议室复制到办公公区、餐饮、商超、酒店、医疗等半结构化室内场景

客户价值验证

每类场景完成 1—2 个真实客户试点;常规配置部署周期目标 ≤4周

阶段商业产出

标准机器人产品与可配置场景任务包,将新增交付由重复研发转为配置复用

阶段四 · 24—36 个月

实现跨行业规模化

验证同一套智能系统在不同本体与成本配置上的复用能力

场景与范围

拓展办公、餐饮、商超、酒店、医疗等行业,并适配不同能力配置的机器人本体

客户价值验证

新增本体以运动学、控制接口和执行约束适配为主,目标适配周期 ≤2周

阶段商业产出

形成跨本体产品组合、标准报价体系和规模化交付流程,支持多客户、多点位复制

附录: 执行本体

概念形态与真机原型

交互执行本体概念形态

概念形态

Concept

原型 · 上下坡

Prototype

原型 · 不平整地面

Prototype

Concept

轮式双臂本体

轮式底盘与双臂统一调度,高度可调,适配办公、商超、家居等空间。

统一调度高度可调近人空间

Performance

整机性能鲁棒稳定

上下坡、不平整地面等移动能力,以及双臂协同操作,均已在真机验证。

上下坡不平整地面双臂协同